Acer Aspire Go Spin hanya 8 jt-an
beli di sini
Laptop Macbook Pro 13 Inchi MD101 2012 - 2015 Core i5 8GB
beli di sini
Meja Komputer Minimalis
beli di sini
Di tengah ledakan kecerdasan artifisial, banyak pengembang dan arsitek sistem terperangkap pada anggapan bahwa performa sistem agen semata-mata ditentukan oleh kecerdasan model dasar (foundation model) seperti Gemini, Claude, atau GPT.
Kita kerap mengira bahwa mengganti model ke versi yang lebih besar secara otomatis akan menyelesaikan alur kerja multi-step yang rumit.
Namun, di lingkungan produksi (production environment), kenyataannya berbeda. Large Language Model (LLM) pada dasarnya hanyalah mesin prediksi token berikutnya (next token prediction) atau mesin pelengkap kalimat (fancy autocomplete).
LLM tidak memiliki kesadaran akan kondisi sistem, tidak bisa mengeksekusi kode secara mandiri, dan tidak tahu kapan sebuah tugas selesai tanpa evaluasi terprogram.
Agar sebuah LLM dapat bertransformasi menjadi AI Agent yang mandiri dan andal, ia membutuhkan infrastruktur kontrol di sekelilingnya. Disiplin rekayasa sistem inilah yang melahirkan paradigma baru: Agentic Harness Engineering.
1. Konsep Dasar: Apa Sebenarnya "Agentic Harness"?
Mengutip definisi Simon Willison:
"An agent is an LLM with tools running in a loop to accomplish a goal."
Jika kita membedah definisi tersebut, kita menemukan bahwa agen AI terdiri dari:
The Brain (LLM): Model kognitif yang memproses bahasa alami dan menentukan penalaran (reasoning).
The Tools: Mekanisme pemanggilan fungsi (function calling) atau protokol integrasi data (seperti Model Context Protocol / MCP) untuk mengambil konteks eksternal di luar data training model, lalu memasukkannya ke sesi percakapan.
The Loop: Siklus programatis yang mengontrol giliran berpikir LLM, menjalankan aksi, dan menilai kemajuan tugas.
Definisi Harness
Agentic Harness adalah segala lapis logika perangkat lunak dan infrastruktur di luar LLM yang membungkus model tersebut sehingga berfungsi sebagai agen.
Harness bukanlah antarmuka pengguna (UI/IDE), melainkan lapisan orkestrasi tingkat rendah (low-level control logic) yang mencakup:
Tool Provisioning & Validation: Cara sistem mendaftarkan fungsi (schema/tools), memvalidasi parameter input sebelum dieksekusi, dan menangani kegagalan alat (error handling/fallbacks).
State & Loop Controller: Mesin eksekusi yang menjaga siklus berpikir (misalnya pola ReAct: Thought-Action-Observation) agar terus berjalan hingga target terpenuhi.
Programmatic Evaluation: Kode deterministik yang secara objektif menginspeksi output LLM untuk menjawab: "Apakah tugas ini sudah benar-benar tuntas, atau apakah agen masih butuh instruksi tambahan?"
Safety & Boundary Guardrails: Pembatasan langkah maksimal (maximum loop iterations), anggaran konsumsi token, serta batasan akses sistem/lingkungan kerja.
2. Mengapa Agentic Harness Engineering Sangat Krusial?
Membangun AI Agent tanpa harness yang matang layaknya memasang mesin jet berperforma tinggi ke rangka sepeda roda dua. Tanpa sasis dan sistem kemudi yang presisi, sistem akan hancur ketika menghadapi variabilitas dunia nyata.
Berikut tiga alasan mendasar mengapa Agentic Harness Engineering menjadi fokus utama para insinyur sistem AI:
A. Mengatasi Sifat Non-Deterministik LLM
LLM bersifat probabilistik. Pada kueri tunggal (single-turn), probabilitas kesalahan mungkin rendah.
Namun, pada alur kerja berulang dengan 10 langkah, jika tiap langkah memiliki akurasi 90%, probabilitas keberhasilan totalnya akan menurun drastis.
Agentic harness bertindak sebagai penjamin kepastian (deterministic guard). Ia memvalidasi sintaks, memeriksa status hasil eksekusi tool, dan mengarahkan ulang agen jika keluar jalur sebelum melangkah ke putaran berikutnya.
B. Pemisahan Antarmuka dan Logika Sistem (Decoupling UI from Harness)
Salah satu wawasan terpenting dalam harness engineering adalah pemisahan antara Harness dan Interface:
Interface: Titik sentuh di mana interaksi dipicu bisa berupa aplikasi chat (Claude Desktop, web app), AI-native editor/IDE (Cursor, Google Anti Gravity, Claude Code), ekstensi CLI, atau bahkan tanpa antarmuka (headless/API pipeline).
Harness: Logika orkestrasi internal yang sama, yang mengatur siklus eksekusi dan alat.
Dengan memisahkan keduanya, tim rekayasa perangkat lunak dapat membangun satu arsitektur inti agen (core harness) yang dapat dipasangkan ke berbagai channel penggunaan tanpa perlu menulis ulang mekanisme penalaran dan integrasi datanya.
C. Efisiensi Biaya dan Pencegahan Infinite Loops
Tanpa evaluasi programatis yang ketat, agen rentan mengalami hallucination loop—memanggil alat yang sama berulang kali dengan parameter serupa saat menemui kegagalan.
Harness yang dirancang dengan baik menyertakan deteksi pola anomali, mekanisme circuit breaker, dan early termination criteria untuk menjaga anggaran token API dan waktu komputasi tetap terkendali.
3. Anatomi Arsitektur Agentic Harness
Berikut adalah alur bagaimana sebuah Agentic Harness mengisolasi dan memandu LLM dalam memecahkan masalah:
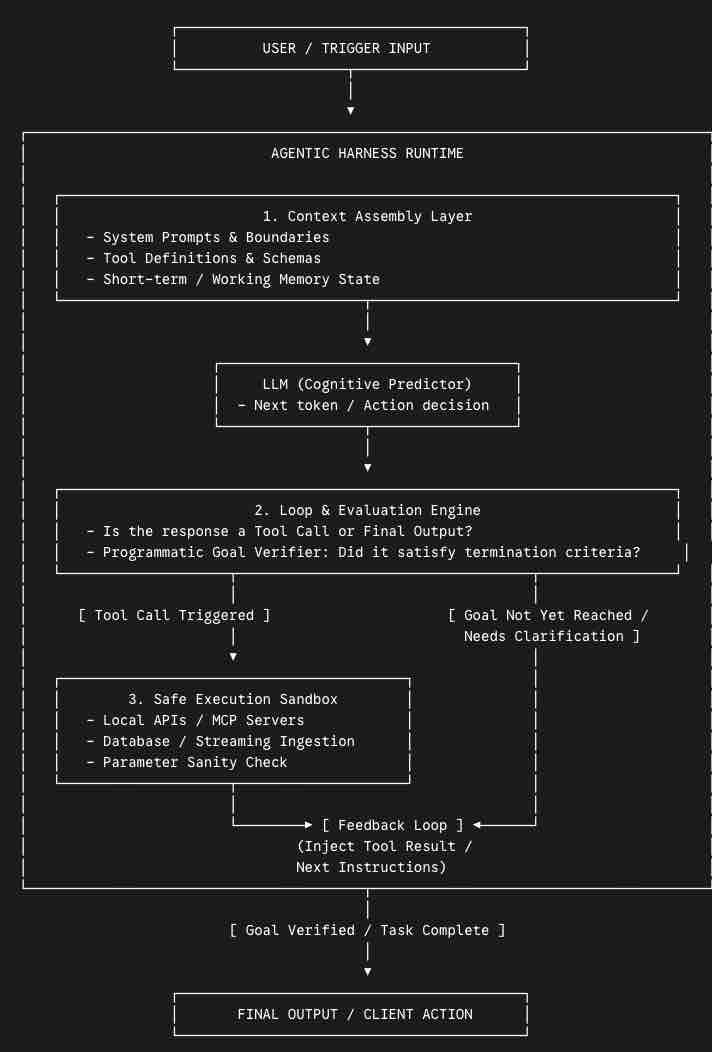 anatomi harness engineering
4. Studi Kasus: Autonomous Git Review & Security Audit Harness
Untuk memahami implementasi konkret dari Agentic Harness Engineering, mari kita telaah sebuah skenario nyata di bidang rekayasa perangkat lunak: Agen Otomatis Peninjau Perubahan Kode dan Keamanan (Local Code Review Agent).
Masalah
Pengembang sering kali menyalin kode mentah dari repositori perusahaan ke antarmuka AI publik untuk mendeteksi bug. Hal ini memicu risiko kebocoran data rahasia (source code leak) dan sering menghasilkan saran yang dangkal karena AI tidak memahami konteks perubahan kode antar-branch.
Desain Solusi Menggunakan Agentic Harness
Alih-alih mengandalkan interaksi chat biasa, kita membangun sebuah harness berbasis kode (misalnya menggunakan bahasa Go atau Python) yang mengendalikan LLM secara lokal:
Penyediaan Tools (Tool Registry):
Harness mendaftarkan tool lokal (misalnya melalui arsitektur Model Context Protocol / MCP) seperti
git_diff(branch_a, branch_b)danread_file_ast(file_path).Akses dibatasi secara ketat (sandbox) pada direktori proyek lokal tanpa mengekspos jaringan luar.
Inisiasi & Konteks Awal:
Pengembang memicu perintah: "Audit perubahan dari branch
stagingkefeature-authterhadap celah keamanan (SQL Injection atau hardcoded credentials)."Harness mengonstruksi prompt sistem, mengunci batasan format laporan, dan menyuntikkan skema tools yang tersedia.
Orkestrasi Loop & Tindakan:
Putaran 1: LLM menganalisis perintah dan memanggil
git_diff("staging", "feature-auth"). Harness menangkap pemanggilan fungsi tersebut, mengeksekusinya secara lokal, dan mengembalikan teks perbedaan kode ke memori kerja agen.Putaran 2: LLM membaca diff dan mendapati adanya modifikasi pada
auth_service.go. LLM meminta pembacaan berkas utuh dengan memanggilread_file_ast("auth_service.go").Putaran 3: LLM menganalisis implementasi kueri dan menemukan penggabungan string mentah pada kueri SQL serta kata sandi administratif yang tertulis langsung (hardcoded). LLM memformulasikan saran perbaikan kode.
Programmatic Evaluation (Evaluator Harness):
Harness memindai output LLM:
Apakah format respon memiliki skema terstruktur (Identifikasi Celah, Bukti Baris Kode, Rekomendasi Solusi)?
Apakah seluruh berkas yang mengalami modifikasi dalam git diff telah diperiksa?
Jika evaluator mendeteksi masih ada berkas modifikasi lain yang belum dianalisis, harness secara programatis mengirim instruksi balik: "Kamu belum memeriksa
token_handler.go. Lanjutkan analisis berkas tersebut sebelum membuat kesimpulan."Begitu semua kriteria terpenuhi, harness mengakhiri putaran dan menampilkan hasil akhir ke terminal pengembang.
Nilai Tambah Harness dalam Studi Kasus Ini
Privasi 100%: Data tidak keluar dari localhost. Harness berkomunikasi melalui protokol lokal (STDIO).
Konsistensi Audit: Evaluator terprogram memastikan agen tidak berhenti sebelum seluruh berkas perubahan benar-benar diaudit secara komprehensif.
Agnostik Interface: Harness audit ini dapat dijalankan sebagai pre-commit hook di terminal, diintegrasikan ke pipeline CI/CD lokal, atau dihubungkan ke aplikasi editor/IDE tanpa mengubah satu baris pun logika inti agennya.
Kesimpulan
Pergeseran terbesar dalam rekayasa AI saat ini bukan lagi seputar siapa yang memiliki model dengan parameter terbesar, melainkan siapa yang mampu merancang harness paling andal di sekitar model tersebut.
Large Language Model menyediakan kapabilitas penalaran umum, namun Agentic Harness Engineering-lah yang mengubah potensi mentah tersebut menjadi solusi perangkat lunak yang aman, terprediksi, dan mampu menyelesaikan masalah nyata secara otonom.